Τι είναι το Robots.txt
Το robots.txt είναι ένα αρχείο κειμένου (text) στο root domain και λέει στους crawlers ποιες διευθύνσεις του site σου (Url) επιτρέπεται να ανιχνεύσουν οι μηχανές αναζήτησης αλλα και τα LLM’s.
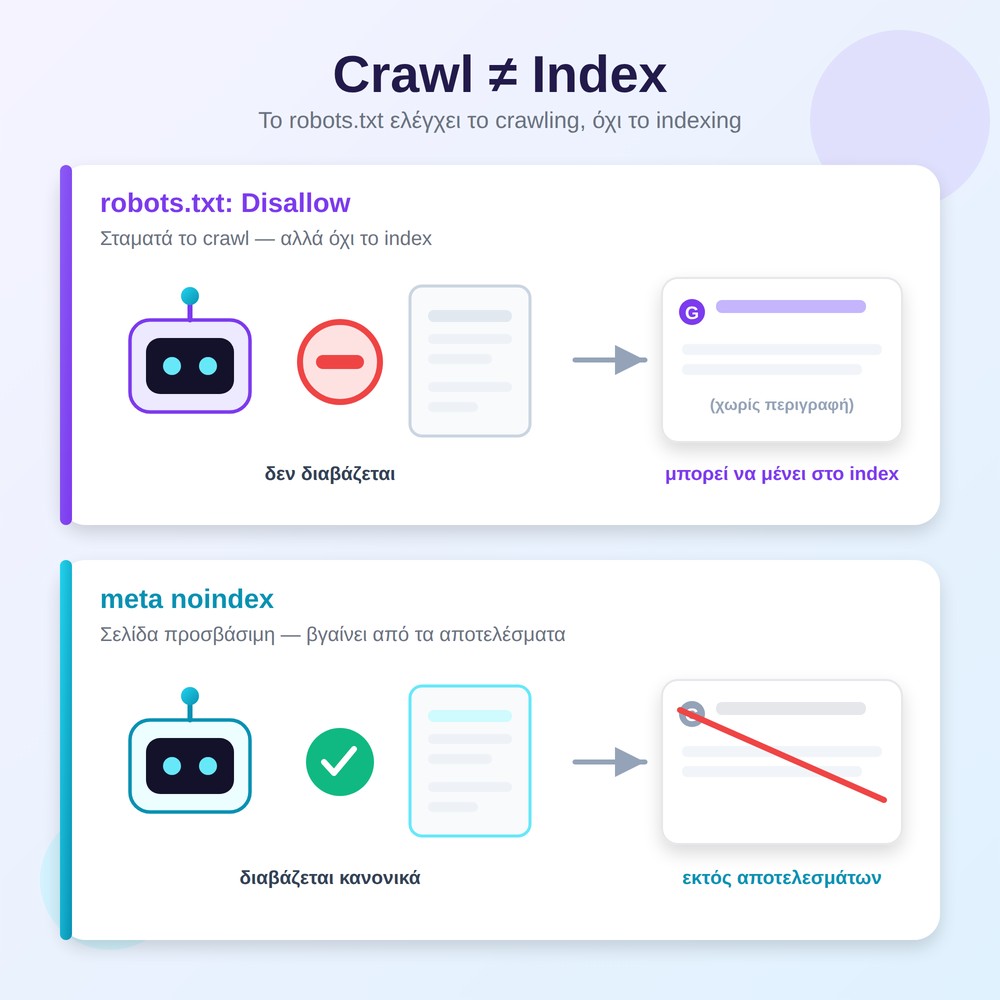
Είναι από τα πιο παρεξηγημένα αρχεία στο τεχνικό SEO. Ένας λάθος κανόνας μπορεί να κρύψει ένα ολόκληρο site από τη Google. To robots.txt ελέγχει το crawling, όχι το indexing. Δεν κρύβει, δηλαδή, μια σελίδα από τα αποτελέσματα της Google.
Παρακάτω θα δεις πώς γράφεται σωστά, και πώς διορθώνεις το μήνυμα «URL που δεν επιτρέπεται από το robots.txt».
Σε ποιον χρησιμεύει το Robots.txt (ανα τύπο site)
Το αρχείο Robots.txt δεν είναι απαραίτητο για όλους με τον ίδιο τρόπο.
Ένα μικρό site παρουσίασης συνήθως δεν χρειάζεται να μπλοκάρει περιεχόμενο. Αντίθετα, ένα μεγάλο e-shop με χιλιάδες διευθύνσεις από φίλτρα απαιτεί αυστηρό έλεγχο, ώστε η Google να μη σπαταλά το crawl budget της σε άχρηστα URLs. Το ίδιο ισχύει για σελίδες διαχείρισης, δοκιμαστικά περιβάλλοντα (staging) ή αρχεία που δεν υπάρχει λόγος να ανιχνεύονται από τις μηχανές αναζήτησης.
Το robots.txt είναι δημόσιο. Οποιοσδήποτε μπορεί να ανοίξει το domain.gr/robots.txt και να δει τι μπλοκάρεις. Γι’ αυτό δεν είναι εργαλείο ασφάλειας. Αν έχεις σελίδες που πρέπει να μείνουν ιδιωτικές, θέλουν προστασία με κωδικό, όχι μια γραμμή Disallow. Αν θες τα βασικά του SEO πριν μπεις στο τεχνικό κομμάτι, δες πρώτα τον οδηγό μας σχετικά με το τι είναι το seo και πως λειτουργεί στη πράξη.

Πώς λειτουργεί η σύνταξη: User-agent, Disallow, Allow, Sitemap
Η σύνταξη στηρίζεται σε τέσσερις βασικές εντολές. Δεν χρειάζεται να τις μάθεις απ’ έξω. Αρκεί να καταλάβεις τι κάνει η καθεμία.
- User-agent: ορίζει σε ποιο bot απευθύνεσαι. Κάθε κανόνας «ανήκει» στο User-agent από πάνω του. Το
*σημαίνει «όλα τα bots». Μπορείς επίσης να στοχεύσεις συγκεκριμένους crawlers, όπωςGooglebot,BingbotήGPTBot. - Disallow: δηλώνει τη διαδρομή που δεν θέλεις να ανιχνευθεί. Το
Disallow: /wp-admin/μπλοκάρει έναν ολόκληρο φάκελο. Το κενόDisallow:σημαίνει «τίποτα μπλοκαρισμένο». - Allow: εξαίρεση μέσα σε μια μπλοκαρισμένη διαδρομή. Χρησιμεύει όταν κλείνεις έναν φάκελο αλλά θες ανοιχτό ένα αρχείο του, π.χ.
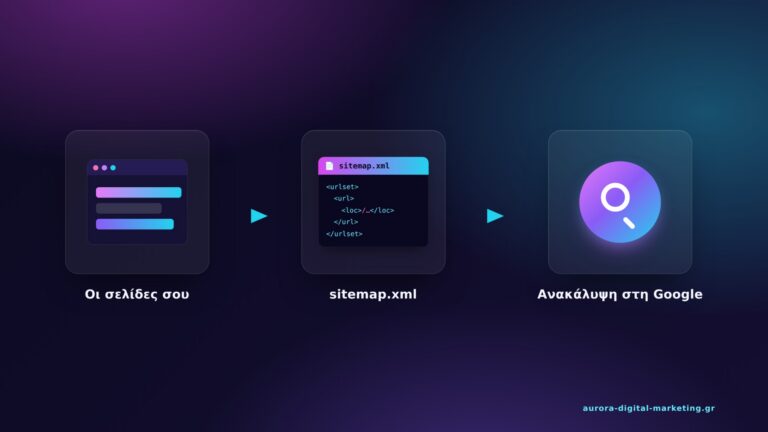
Disallow: /wp-admin/μαζί μεAllow: /wp-admin/admin-ajax.php. - Sitemap: δείχνει στο bot πού βρίσκεται το sitemap του site σου. Έτσι η Google ανακαλύπτει πιο εύκολα τις σελίδες σου. Μπαίνει πάντα με πλήρες URL. Δείτε πιο αναλυτικά τι είναι το sitemal.xml και παραδείγματα.
Δύο λεπτομέρειες που μπερδεύουν συχνά. Πρώτον, τα paths είναι case-sensitive: το /Blog/ και το /blog/ δεν είναι το ίδιο. Δεύτερον, μπορείς να χρησιμοποιήσεις μπαλαντέρ. Το * ταιριάζει με οποιονδήποτε χαρακτήρα και το $ δηλώνει το τέλος της διεύθυνσης. Όταν ένας κανόνας Allow και ένας Disallow συγκρούονται, υπερισχύει ο πιο συγκεκριμένος.
Παραδειγμα robots.txt, γραμμή γραμμή
# Κανόνες για όλα τα bots
User-agent: *
Disallow: /wp-admin/          # περιοχή διαχείρισης
Allow: /wp-admin/admin-ajax.php  # εξαίρεση, το χρειάζεται το θέμα
Disallow: /?s=               # εσωτερική αναζήτηση
Disallow: /cart/             # καλάθι, δεν έχει λόγο να ανιχνεύεται

# Δήλωση του sitemap
Sitemap: https://aurora-digital-marketing.gr/sitemap_index.xml
Η επίσημη τεκμηρίωση της Google εξηγεί αναλυτικά κάθε εντολή, αν θες να πας βαθύτερα δες το Introduction to robots.txt στο Google Search Central.
Δοκίμασε το αρχείο σου πριν πάει live. Ένα λάθος Disallow μπορεί να κρύψει κρίσιμες σελίδες. Πέρασέ το από το robots.txt validator tester μας και δες ποια URLs επιτρέπονται και ποια μπλοκάρονται.
Disallow δεν σημαίνει noindex
Το Disallow εμποδίζει το crawling, όχι το indexing. Αυτή η διαφορά είναι ο λόγος που δημιουργείται το σφάλμα που ψάχνεις. Όταν μπλοκάρεις μια σελίδα στο robots.txt, λες στη Google «μην τη διαβάσεις». Δεν της λες «μην τη δείξεις».
Στην πράξη, αν άλλα sites έχουν συνδέσμους (backlinks) προς μια μπλοκαρισμένη διεύθυνση, η Google μπορεί να την εμφανίσει στα αποτελέσματα. Tότε θα δεις στο Search Console την κατάσταση «Indexed, though blocked by robots.txt».
Για να αφαιρέσεις πραγματικά μια σελίδα από τα αποτελέσματα, χρειάζεσαι την ετικέτα meta noindex.
Μεγάλη προσοχή σε μια παγίδα: μην μπλοκάρεις στο robots.txt μια σελίδα που έχει noindex. Αν η Google δεν μπορεί να την ανιχνεύσει, δεν θα δει ποτέ το noindex, και η σελίδα θα μείνει στο index.
| Τι θέλεις να πετύχεις | robots.txt Disallow | meta noindex |
|---|---|---|
| Να μη σπαταλιέται crawl budget σε άχρηστα URL | Ναι | Όχι |
| Να μη φαίνεται μια σελίδα στα αποτελέσματα | Όχι | Ναι |
| Να αφαιρεθεί μια ήδη indexed σελίδα | Όχι, άφησέ τη προσβάσιμη | Ναι |
«URL που δεν επιτρέπεται από το robots.txt»: τι σημαίνει και πώς το διορθώνεις
Το μήνυμα σημαίνει ότι το robots.txt μπλοκάρει μια διεύθυνση που θέλεις να ανιχνευθεί. Η λύση είναι να βρείς τον κανόνα που μπλοκάρει και άλλαξέ τον.
Πρώτα, σιγουρέψου ότι είναι όντως πρόβλημα. Το «Blocked by robots.txt» δεν είναι πάντα κακό. Πολλά URLs είναι μπλοκαρισμένα επίτηδες και σωστά, γιατί το μπλοκάρισμα βοηθά στο crawl management. Το να μπλοκάρεις url και patterns με χαμηλή αξία βοηθά την Google να εντοπίσει και να ευρετηρίασει (index) μονο τις ποιοτικές σου σελίδες. Το να βρεί μη ποιοτικές (duplicates, empty, thin content κτλ) χαλάει την εικόνα όλου του site στα μάτια της Google.
Τυπικά URLs που θέλεις μπλοκαρισμένα:
- εσωτερικά αποτελέσματα αναζήτησης (
/?s=,/search) - σελίδες με φίλτρα και άπειρα παραμετρικά URLs (faceted navigation)
- καλάθι, ταμείο, λογαριασμός χρήστη και σελίδες «ευχαριστούμε»
- admin περιοχές και staging περιβάλλοντα
Σε αυτές τις περιπτώσεις η ένδειξη είναι αναμενόμενη και δεν χρειάζεται καμία ενέργεια. Πρόβλημα υπάρχει μόνο όταν μπλοκάρεται μια σελίδα που θέλεις στη Google, όπως ένα προϊόν, μια κατηγορία ή ένα σημαντικό άρθρο. Τότε η Google δεν μπορεί να τη δει ούτε να την κατατάξει.
Στο Google Search Console
Εδώ το βλέπεις ως «Blocked by robots.txt» στην αναφορά Page indexing. Άνοιξε το εργαλείο URL Inspection και έλεγξε τη συγκεκριμένη διεύθυνση. Θα σου δείξει ποιος κανόνας την μπλοκάρει. Βρες αυτή τη γραμμή Disallow στο robots.txt και είτε αφαίρεσέ τη, είτε πρόσθεσε ένα πιο συγκεκριμένο Allow από πάνω. Μόλις το αλλάξεις, πάτησε Validate Fix, ώστε η Google να ξαναελέγξει.
Έλεγξε το URL πριν και μετά τη διόρθωση. Βάλε τη διεύθυνση που σε ανησυχεί στο robots.txt validator tester μας και δες άμεσα αν επιτρέπεται ή μπλοκάρεται, καθώς και ποιος ακριβώς κανόνας ευθύνεται.
Στο Merchant Center και στις εικόνες
Στα προϊόντα και τις εικόνες, το μήνυμα λέει «δεν είναι ανιχνεύσιμη λόγω του robots.txt». Συνήθως μπλοκάρεται το Googlebot ή το Googlebot-Image, οπότε η Google δεν μπορεί να ελέγξει τη σελίδα προϊόντος.
User-agent: Googlebot
Disallow:

User-agent: Googlebot-Image
Disallow:
Το κενό μετά το Disallow σημαίνει «μην μπλοκάρεις τίποτα». Δώσε στη Google 24 έως 72 ώρες να ξαναδιαβάσει το αρχείο πριν περιμένεις αλλαγή.
Μια συχνή αιτία που μπερδεύει: αν χρησιμοποιείς Cloudflare, ίσως δεις αυτό το σφάλμα χωρίς να έχεις γράψει εσύ κανέναν κανόνα. Η Cloudflare μπορεί να σερβίρει ένα δικό της managed robots.txt με προεπιλεγμένους περιορισμούς. Έλεγξε τις ρυθμίσεις bot της, όχι μόνο το αρχείο του site σου.
Content-Signal: το νέο πεδίο για τα AI bots και γιατί να μην το εμπιστεύεσαι τυφλά
Αν ανοίξεις κάποιο robots.txt σήμερα, ίσως δεις μια γραμμή σαν αυτή:
Content-Signal: ai-train=no, search=yes, ai-input=yes
Είναι μια δήλωση προτίμησης για το πώς επιτρέπεις να χρησιμοποιείται το περιεχόμενό σου. Την εισήγαγε η Cloudflare τον Σεπτέμβριο του 2025, ως μέρος του Content Signals Policy. Οι τρεις τιμές διαβάζονται εύκολα:
- search=yes: επιτρέπεις κανονική ανίχνευση και εμφάνιση στα αποτελέσματα αναζήτησης.
- ai-input=yes: επιτρέπεις σε AI εργαλεία να χρησιμοποιούν το περιεχόμενο για απαντήσεις σε πραγματικό χρόνο.
- ai-train=no: δηλώνεις ότι δεν θέλεις να χρησιμοποιηθεί για εκπαίδευση μοντέλων.
Εδώ χρειάζεται ειλικρίνεια. Το Content-Signal δεν είναι τεχνικός μηχανισμός επιβολής. Λειτουργεί με τιμή, όχι με τείχος. Η Google δήλωσε ρητά ότι το αγνοεί εντελώς στα crawlers και τα μοντέλα της. Επειδή δεν είναι επίσημο πρότυπο, κάποια εργαλεία ελέγχου μπορεί να το επισημάνουν ως άγνωστη εντολή.
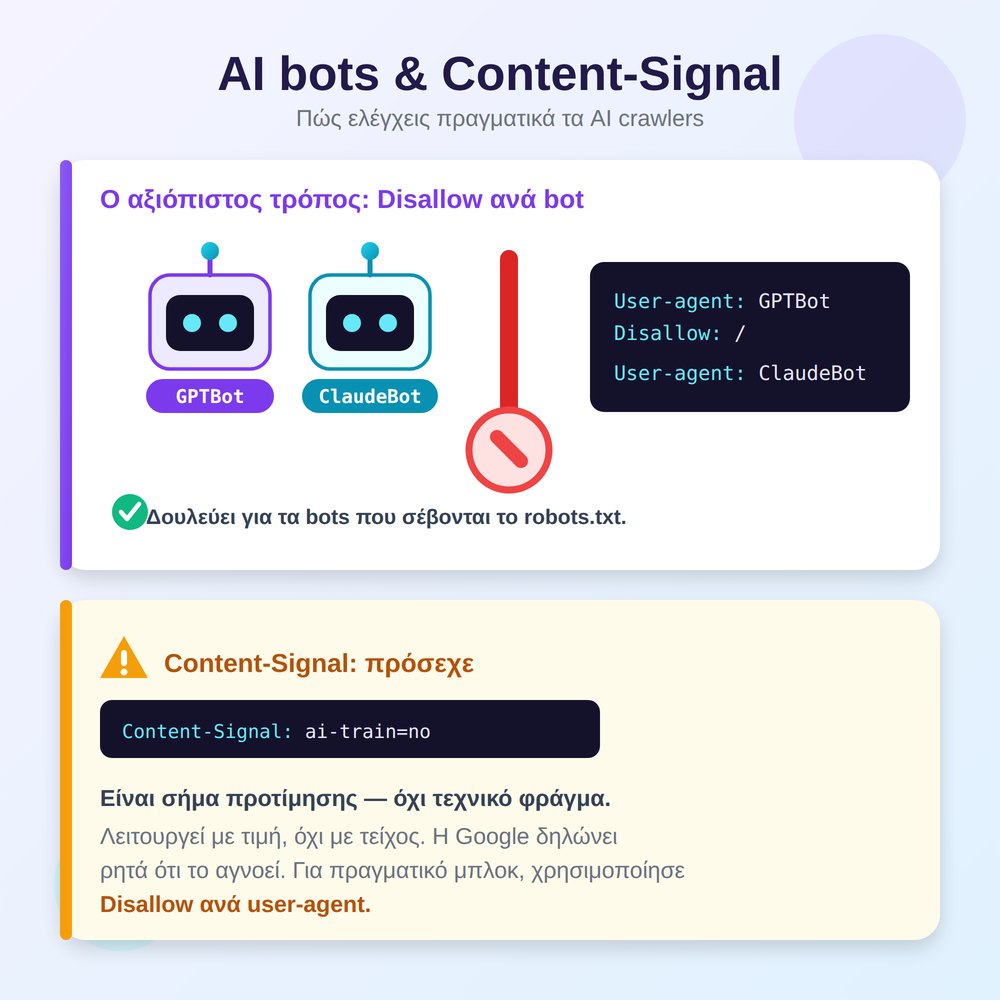
Αν θες όντως να περιορίσεις τα AI bots από την εκπαίδευση, ο αξιόπιστος τρόπος παραμένει το κλασικό Disallow ανά user-agent:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /
Και πάλι, αυτό δουλεύει μόνο για τα bots που σέβονται το robots.txt. Για πραγματικό μπλοκάρισμα κακόβουλων scrapers, χρειάζεσαι bot management σε επίπεδο server.
Πώς θα βρω το robots.txt του WordPress για να το επεξεργαστώ
Σε WordPress δεν χρειάζεται να αγγίξεις τον server. Τα δημοφιλή SEO plugins έχουν έτοιμο επεξεργαστή robots.txt μέσα από το διαχειριστικό. Οι πιο συνηθισμένες επιλογές:
- Rank Math: Rank Math, μετά General Settings, μετά Edit robots.txt.
- Yoast SEO: Yoast SEO, μετά Tools, μετά File editor.
- All in One SEO: All in One SEO, μετά Tools, μετά Robots.txt Editor.
Αν δεν χρησιμοποιείς κάποιο plugin, το αρχείο επεξεργάζεται και χειροκίνητα. Συνδέσου με FTP ή με τον File Manager του hosting, και άνοιξε ή δημιούργησε το robots.txt στη ρίζα του domain. Το ίδιο ισχύει σε sites εκτός WordPress: ένα απλό αρχείο κειμένου στη ρίζα αρκεί.
Μια σημείωση για το WordPress: αν δεν υπάρχει φυσικό αρχείο, το ίδιο το WordPress παράγει ένα εικονικό robots.txt. Δεν το βλέπεις ως αρχείο στον server, αλλά υπάρχει. Μόλις το επεξεργαστείς μέσα από ένα plugin, δημιουργείται πλέον πραγματικό αρχείο.
Ο έλεγχος είναι εξίσου σημαντικός με τη δημιουργία. Μετά από κάθε αλλαγή, δοκίμασε συγκεκριμένες διευθύνσεις με το URL Inspection στο Search Console. Θα σου πει καθαρά αν μια σελίδα είναι crawlable ή μπλοκαρισμένη. Είναι πέντε λεπτά δουλειάς που σε γλιτώνει από ακούσια μπλοκαρίσματα.
Συχνά λάθη που κοστίζουν οργανική ορατότητα
Τα περισσότερα προβλήματα με το robots.txt δεν είναι εξωτικά. Είναι λίγα, τα ίδια, και επαναλαμβάνονται:
- Disallow: / σε live site. Μπλοκάρει ολόκληρο το site. Συμβαίνει συχνά όταν μένει από το staging.
- Μπλοκάρισμα των αρχείων CSS και JavaScript. Χωρίς αυτά, η Google δεν βλέπει σωστά τη σελίδα.
- Χρήση του robots.txt για «ασφάλεια». Το αρχείο είναι δημόσιο, οπότε απλώς δείχνεις πού είναι τα κρυφά σου.
- Μπλοκάρισμα σελίδας που θες να κάνεις noindex. Η Google δεν θα δει ποτέ την ετικέτα.
- Λάθος στα κεφαλαία των paths. Το
/Category/δεν μπλοκάρει το/category/.
Συχνές ερωτήσεις
Πού πρέπει να βρίσκεται το αρχείο robots.txt;
Πάντα στο root του domain, στη διεύθυνση domain.gr/robots.txt. Σε υποφακέλους δεν το διαβάζει κανένα bot.
Χρειάζεται κάθε ιστοσελίδα robots.txt;
Όχι υποχρεωτικά. Ένα μικρό site χωρίς αρχείο απλώς επιτρέπει την ανίχνευση των πάντων. Από μεσαίο μέγεθος και πάνω, όμως, ο έλεγχος βοηθάει.
Το Disallow αφαιρεί μια σελίδα από το Google;
Όχι το Disallow δεν αφαιρεί μια σελίδα από το Google. Εμποδίζει μόνο την ανίχνευση. Για αφαίρεση από τα αποτελέσματα, χρειάζεσαι meta noindex με τη σελίδα προσβάσιμη.
Γιατί βλέπω «Indexed, though blocked by robots.txt»;
Επειδή η σελίδα έχει εξωτερικούς συνδέσμους και η Google την κατέγραψε χωρίς να τη διαβάσει. Αν δεν τη θες στο index, άφησέ τη crawlable και βάλε noindex.
Μπορεί το robots.txt να προστατεύσει ευαίσθητες σελίδες;
Όχι. Είναι δημόσιο αρχείο. Για προστασία, χρησιμοποίησε κωδικό ή περιορισμό πρόσβασης σε επίπεδο server.
Πρέπει να μπλοκάρω τα AI bots;
Εξαρτάται από τη στρατηγική σου. Αν θες ορατότητα σε AI απαντήσεις, ίσως όχι. Αν θες να αποτρέψεις χρήση για εκπαίδευση, μπλόκαρε GPTBot και ClaudeBot με Disallow, όχι με το Content-Signal.
Πώς ξέρω αν μπλοκάρω κατά λάθος τα AI bots;
Άνοιξε το robots.txt σου και ψάξε για Disallow: / κάτω από user-agent όπως GPTBot ή ClaudeBot. Πρόσεξε και τυχόν καθολικό Disallow: / στο User-agent: *, γιατί πιάνει και τα AI bots. Ένας robots.txt tester σου δείχνει ανά bot τι επιτρέπεται.
Πώς σχετίζεται το robots.txt με το crawl budget;
Μπλοκάροντας άχρηστες διευθύνσεις, κατευθύνεις τα crawlers στις σελίδες που έχουν σημασία. Σε μεγάλα sites, αυτό βοηθά τη Google να ανιχνεύει συχνότερα προϊόντα και άρθρα, αντί για ατελείωτα URL φίλτρων. Σε μικρά sites η επίδραση είναι αμελητέα.
Πώς ελέγχω αν το robots.txt μου λειτουργεί σωστά;
Χρησιμοποίησε το URL Inspection στο Google Search Console για συγκεκριμένες διευθύνσεις. Θα σου πει αν κάθε σελίδα είναι crawlable ή μπλοκαρισμένη, και ποιος κανόνας ευθύνεται. Έλεγξε πάντα μετά από κάθε αλλαγή.
Το ουσιαστικό συμπέρασμα
Αν κρατήσεις ένα πράγμα, κράτα τη διαφορά ανάμεσα σε crawling και indexing. Το robots.txt διαχειρίζεται το πρώτο, όχι το δεύτερο. Τα περισσότερα σφάλματα τύπου «URL που δεν επιτρέπεται» ξεκινούν από αυτή την παρανόηση, και λύνονται μόλις τη ξεκαθαρίσεις.
Δεν είσαι σίγουρος τι μπλοκάρει το robots.txt σου; Ένα τεχνικό SEO audit εντοπίζει σελίδες που χάνεις χωρίς να το ξέρεις, από λάθος Disallow μέχρι crawl budget που πάει χαμένο. Δες αναλυτικά τις υπηρεσίες SEO και μάθετε πως μπορούμε να σας βοηθήσουμε.